

Les outils d’intelligence artificielle (IA) générative se sont installés en quelques années dans le travail quotidien des chercheurs. Cet article fait le point sur ce que les données disent de cette diffusion, sur les principaux risques qu’elle comporte pour l’intégrité de la rédaction scientifique et sur les normes qui se dessinent chez les éditeurs. Il propose ensuite un cadre pratique d’utilisation responsable. L’argument central est simple : l’IA ne modifie pas les exigences fondamentales de la rédaction scientifique, elle les rend plus pressantes. Un texte fluide est désormais peu coûteux à produire ; la valeur d’un article tient d’autant plus à la clarté de sa question, à la solidité de ses preuves et à l’honnêteté avec laquelle il expose ses incertitudes.
En 2025, 84 % des chercheurs interrogés par l’éditeur Wiley déclaraient utiliser des outils d’IA, contre 57 % un an plus tôt (Wiley, 2025). Dans le même temps, des analyses portant sur des millions de résumés montrent que la trace de ces outils est désormais détectable dans la littérature publiée (Liang et al., 2025 ; Kobak et al., 2025). La question n’est donc plus de savoir si l’IA fait partie de la rédaction scientifique, mais comment l’utiliser sans compromettre ce qui fait la valeur de la recherche : l’exactitude, la transparence et la responsabilité de l’auteur.
Cet article s’adresse à l’ensemble du personnel de recherche, des assistants aux chercheurs confirmés, ainsi qu’aux équipes de communication. Il s’organise en quatre temps : un rappel des fondements d’une bonne rédaction scientifique ; un état des lieux de l’usage de l’IA et de ses implications plus larges pour la production de connaissances ; une analyse des risques, illustrée par des exemples ; enfin, les normes des éditeurs et un cadre pratique pour un usage responsable.
Les fondements d’une bonne rédaction scientifique
Quatre qualités distinguent un bon texte scientifique. Il pose une question claire et explique pourquoi elle importe pour les politiques ou la pratique. Il développe un argument logique, chaque section s’appuyant sur la précédente. Il formule des affirmations fondées sur les preuves, sans présenter une corrélation comme une relation de causalité. Enfin, il expose honnêtement ses incertitudes : limites, validité externe et intervalles de confiance.
La structure IMRaD (Introduction, Méthodes, Résultats, Discussion) reste la norme pour les articles empiriques, parce que chaque partie répond à une question précise. L’introduction dit pourquoi le sujet importe et quelle lacune l’étude comble ; les méthodes décrivent ce qui a été fait, avec assez de précision pour être reproduit ; les résultats présentent ce qui a été trouvé, sans interprétation ; la discussion explique ce que cela signifie et quelles en sont les limites. Les outils d’IA ont tendance à brouiller ces rôles, par exemple en glissant de l’interprétation dans les résultats ou de nouvelles affirmations dans la conclusion.
L’exemple suivant, construit pour cet article avec des chiffres fictifs, illustre l’écart entre une affirmation excessive et une affirmation calibrée :
Formulation excessive : « Les confinements ont fait exploser l’insécurité alimentaire à travers l’Afrique, prouvant que les restrictions de mouvement dévastent les ménages ruraux. »
Formulation calibrée : « Dans notre panel téléphonique de ménages ruraux de [pays], la part des ménages déclarant une insécurité alimentaire modérée ou grave a augmenté de 12 points de pourcentage (IC à 95 % : 8–16) après le début du confinement. »
La première version emploie un langage causal à partir de corrélations d’enquête, généralise d’un échantillon à un continent et n’indique aucune ampleur. La seconde précise le dispositif, l’échantillon, le contexte, l’ampleur de l’effet et son incertitude. Or les textes retravaillés par l’IA dérivent souvent vers la première forme, parce que ces outils privilégient les formulations assurées et englobantes. Le critère ultime demeure : un lecteur pourrait-il reconstituer ce que vous avez fait et juger si vos conclusions en découlent ?
L’IA dans la rédaction scientifique : ce que montrent les données
Une adoption rapide
Les enquêtes ExplanAItions de Wiley indiquent que l’utilisation d’outils d’IA, toutes tâches confondues, est passée de 57 % en 2024 à 84 % en 2025, et que leur usage pour des tâches de recherche et de publication est passé de 45 % à 62 % (figure 1). Plus de la moitié des répondants (57 %) citent l’absence de lignes directrices et de formation comme un frein majeur. Ces chiffres appellent la prudence : il s’agit de déclarations recueillies par un éditeur commercial auprès d’un échantillon non aléatoire de 2 430 chercheurs, avec une définition large de l’« utilisation ». Ils ne sont pas directement comparables à ceux d’autres enquêtes.
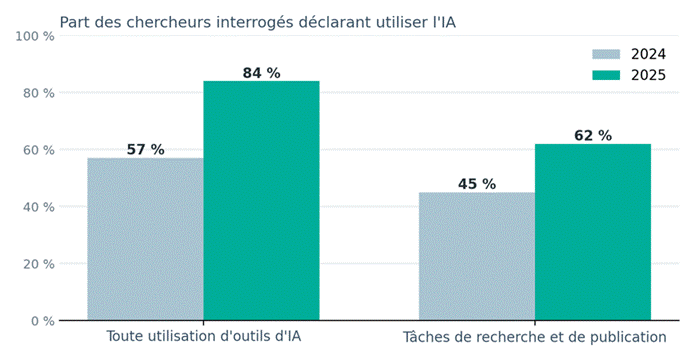
Figure 1. Utilisation déclarée d’outils d’IA par les chercheurs, 2024–2025. Source : Wiley (2025), ExplanAItions. Échantillon non aléatoire, données déclaratives.
Une empreinte visible dans la littérature
Deux études de grande ampleur estiment la part de textes modifiés par des grands modèles de langage à partir de l’évolution de la fréquence de certains mots, dont l’usage a bondi après l’apparition de ChatGPT. Liang et al. (2025) estiment cette part à 22 % au plus pour les articles d’informatique et à 9 % au plus pour les mathématiques et les revues du groupe Nature entre 2020 et 2024. Kobak et al. (2025) estiment qu’au moins 13,5 % des résumés biomédicaux indexés dans PubMed en 2024 ont été traités par un tel modèle. Il s’agit d’estimations au niveau du corpus, et non de classements d’articles individuels ; elles renseignent sur la prévalence, pas sur le caractère approprié ou déclaré de l’usage.
Où les chercheurs placent-ils la limite ?
Une enquête de Nature auprès d’environ 5 000 chercheurs montre une large acceptation de l’IA pour la correction linguistique et la traduction, des avis partagés sur la rédaction de sections d’articles ou de rapports d’évaluation par les pairs, et un rejet de son usage pour produire des résultats ou se substituer au jugement de l’auteur (Kwon, 2025). La tendance générale est claire : plus une tâche façonne le contenu et les conclusions, moins l’assistance de l’IA est jugée acceptable.
Au-delà de la rédaction : l’IA et la frontière des connaissances
L’enjeu dépasse la rédaction. Dans un article récent, nous suggérons que les systèmes alimentaires ont peut-être fonctionné non seulement en deçà de leur potentiel de production, mais aussi en deçà de leur frontière effective de connaissances (Ulimwengu, 2026). Cette frontière désigne la compréhension maximale, utile à la décision, qui peut être tirée des observations, des connaissances scientifiques et des savoirs locaux disponibles, compte tenu des capacités analytiques, informatiques et institutionnelles existantes.
Dans la vision conventionnelle, une base de connaissances largement fixe alimente les technologies et les décisions, et l’inefficacité maintient la performance observée en deçà d’une frontière de production déjà définie. Dans la vision proposée, la connaissance utilisable est endogène : les observations, les connaissances scientifiques et les savoirs locaux doivent passer par une capacité d’intégration des connaissances, que l’IA, l’interopérabilité des données et de meilleures mesures peuvent élargir (figure 2). Ce raisonnement prolonge les travaux qui considèrent l’IA comme une partie de l’infrastructure épistémique des systèmes alimentaires (van Wassenaer, 2026).
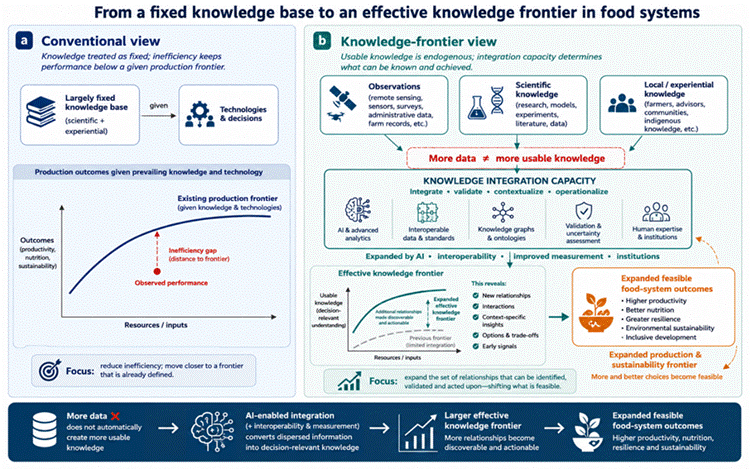
Figure 2. D’une base de connaissances fixe à une frontière effective de connaissances dans les systèmes alimentaires (figure en anglais). Source : Ulimwengu (2026a), composition de l’auteur.
Ce cadre conceptuel, qui n’est pas une estimation empirique, comporte d’importantes mises en garde pour les auteurs. Davantage de données ne signifie pas davantage de connaissances utilisables. Une précision prédictive n’équivaut pas à une compréhension causale. L’IA peut élargir ce qui est inférable sans élargir ce qui est réalisable. Enfin, la frontière peut se déplacer de façon inégale : les systèmes agricoles peu observés, peu numérisés ou mal connectés, comme de nombreux systèmes de petits exploitants, risquent d’être moins « lisibles » pour l’IA. La progression pertinente va de l’observation à l’inférence, de l’inférence à la validation, de la validation à la pertinence décisionnelle, puis à l’action.
Les risques à maîtriser
Des références fabriquées
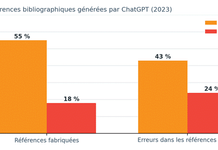
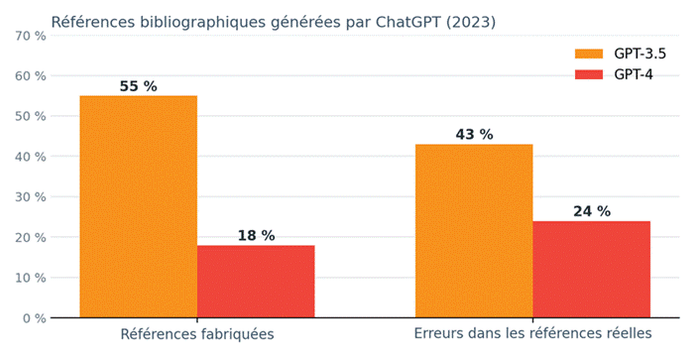
Le risque le mieux documenté est la fabrication de références. Walters et Wilder (2023) ont demandé à ChatGPT de rédiger de courtes revues de littérature sur 42 sujets, produisant 636 références : 55 % des références générées par GPT-3.5 et 18 % de celles générées par GPT-4 n’existaient pas. Parmi les références réelles, 43 % (GPT-3.5) et 24 % (GPT-4) comportaient des erreurs substantielles (figure 3). Les modèles plus récents et les outils connectés à des moteurs de recherche font mieux, mais le taux d’erreur n’est pas nul.
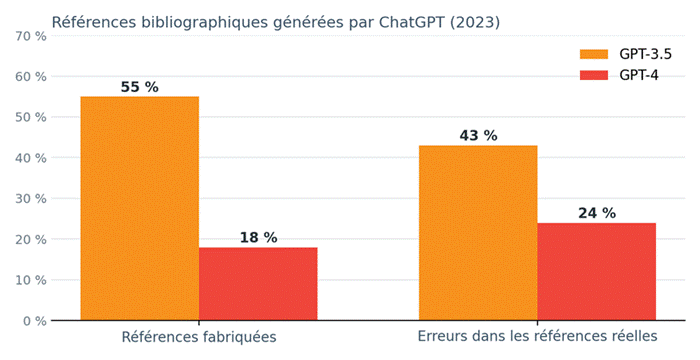
Figure 3. Références fabriquées et erronées produites par ChatGPT. Source : Walters & Wilder (2023), Scientific Reports. Versions de 2023 ; les taux varient selon la tâche et l’outil.
Les fausses références sont plausibles : vraies revues, auteurs aux noms crédibles, identifiants DOI bien formés. Quatre vérifications s’imposent pour toute référence suggérée par un outil d’IA : le DOI renvoie-t-il bien à l’article cité ? Le titre exact figure-t-il dans Google Scholar, Crossref ou sur le site de la revue ? Les auteurs, l’année, le volume et les pages correspondent-ils à la notice de l’éditeur ? Et surtout, la source dit-elle réellement ce pour quoi on la cite ? Citer une source qu’on n’a pas lue relève de l’intégrité scientifique, quel que soit l’outil qui l’a proposée.
Autres risques
- Confidentialité et données. Des résultats non publiés, des microdonnées d’enquête ou des informations permettant d’identifier une personne, saisis dans des outils externes, peuvent être stockés ou réutilisés. Selon la politique de gouvernance des données de l’IFPRI, les données confidentielles, dont les informations permettant d’identifier une personne, ne doivent pas être saisies dans des outils d’IA.
- Plagiat et attribution. Le texte généré peut reprendre des sources sans les citer ; les idées perdent leur provenance.
- Biais et angles morts. Les données d’entraînement sous-représentent les pays du Sud, les langues locales et la littérature grise.
- Perte de la voix et des compétences. Une dépendance excessive uniformise le style et affaiblit l’apprentissage de la rédaction chez les chercheurs en début de carrière.
- Homogénéisation de la science. Formulations et cadrages similaires d’un article à l’autre ; moins d’angles originaux.
- Responsabilité. L’IA ne peut pas assumer de responsabilité ; les auteurs répondent de chaque mot, chaque chiffre et chaque référence.
Étude de cas : quand une précision parfaite est un signal d’alerte
Le document de travail IFPRI n° 1783 (Ulimwengu, 2026b) utilise des grands modèles de langage comme instruments de mesure. Il code 206 documents publics sur la sécurité alimentaire provenant de dix pays africains (2010–2025) en variables de sévérité, de cadrage narratif, de ton et d’attribution causale. Comparés aux phases de référence (IPC, FEWS NET, Cadre Harmonisé), les scores obtenus dans l’échantillon de validation exploratoire affichent une exactitude, une précision, un rappel et un score F1 de 1,00.
Ce résultat parfait est pourtant un signal d’alerte plutôt qu’une réussite. Dans cet échantillon, 82 des 83 documents présentent une « fuite » élevée : la phase de référence figure déjà dans le texte codé. Dans l’échantillon strict, 17 des 18 documents sont dans ce cas, et tous relèvent des phases 4 et 5. L’accord observé reflète donc en grande partie la reconnaissance d’une information déjà présente, et non une mesure indépendante. Le document en tire la conclusion qui s’impose : il démontre la faisabilité et la cohérence interne d’une chaîne de mesure transparente, sans établir sa validité indépendante.
Les leçons dépassent ce cas : traiter les sorties d’un modèle de langage comme des variables générées, entachées d’erreurs de mesure ; repérer les fuites et séparer échantillons stricts et exploratoires ; documenter l’invite, la version du modèle, le livre de codes et le protocole de validation ; dire explicitement ce que les résultats ne montrent pas ; et utiliser ces mesures en complément, et non en remplacement, des systèmes existants comme l’IPC et les enquêtes auprès des ménages.
Ce qu’exigent les éditeurs
Les politiques éditoriales convergent sur trois points : l’IA ne peut pas être auteur ; tout usage allant au-delà de la simple correction linguistique doit être déclaré ; les auteurs restent pleinement responsables. Les règles concernant les images sont plus strictes (tableau 1). Ces politiques évoluent rapidement ; il convient de vérifier la version en vigueur pour chaque revue visée.
Tableau 1. Synthèse des positions de quelques organismes et éditeurs.
| Organisme | L’IA peut-elle être auteur ? | Déclaration de l’usage | Remarques |
| COPE (2023) | Non | Décrire l’outil et son usage dans la section Méthodes ou équivalente | Les auteurs restent entièrement responsables du contenu |
| ICMJE | Non | Dans la lettre d’accompagnement et dans le manuscrit | Les humains doivent vérifier l’exactitude et les références |
| Springer Nature | Non | Documenter l’usage des grands modèles de langage dans les Méthodes | La simple relecture linguistique est exemptée ; images générées par IA en principe non autorisées |
| Elsevier | Non | Déclaration spécifique sur l’usage de l’IA | Images générées par IA restreintes ; l’outil ne remplace pas le jugement de l’auteur |
Un cadre pratique pour un usage responsable
Un code coloré
Le code suivant est un repère pratique, et non une politique officielle de l’IFPRI. Il ne dispense pas de respecter les règles de la revue visée et de l’institution.
- Vert (avec vérification humaine) : améliorer la grammaire et la clarté de son propre texte ; traduire son propre brouillon ; proposer des plans ou des titres ; déboguer un code que l’on comprend.
- Orange (vérifier et déclarer) : rédiger à partir de ses notes et de ses résultats ; résumer des articles que l’on lira en entier ; repérer de la littérature, puis lire les sources ; générer du code d’analyse.
- Rouge (à éviter) : saisir des informations permettant d’identifier une personne, des données confidentielles ou sous embargo ; citer des références non lues ; générer ou modifier des données, des résultats ou des images ; évaluer des manuscrits reçus à titre confidentiel.
Un flux de travail où l’humain garde la main
Un usage responsable suit cinq étapes. Planifier : l’auteur reste maître de la question, de l’argument et des preuves. Formuler l’invite : confier une tâche délimitée, sans données confidentielles. Vérifier : contrôler chaque fait, chaque chiffre et chaque référence. Réviser : réécrire avec sa propre voix et garder des affirmations calibrées. Déclarer : consigner l’outil, sa version et l’usage qui en a été fait. Les étapes le plus souvent négligées sont la vérification et la déclaration. Une règle simple résume l’ensemble : si vous ne pouvez pas expliquer et défendre une phrase, un chiffre ou une référence sans l’outil, le texte n’est pas prêt à être soumis.
Exemple d’invites
Une invite faible demande à l’outil de produire le contenu, les sources et les conclusions :
« Rédige une revue de littérature sur les confinements liés à la COVID-19 et la sécurité alimentaire en Afrique, avec 15 références. »
Une invite responsable fournit le texte de l’auteur, limite la tâche à la révision, interdit l’ajout d’affirmations ou de sources, et fait de l’outil un lecteur critique plutôt qu’un prête-plume :
« Voici mon paragraphe. Améliore sa clarté et sa concision. N’ajoute ni affirmation ni source. Signale toute phrase où l’affirmation semble plus forte que les preuves. »
Déclarer et citer l’usage de l’IA
La formulation suivante reprend le modèle courant proposé par plusieurs éditeurs ; elle doit être adaptée à l’emplacement exigé par la revue (Méthodes, Remerciements ou déclaration spécifique) :
« Lors de la préparation de ce travail, l’auteur ou les auteurs ont utilisé [nom de l’outil, version] pour [améliorer la langue et la lisibilité des sections 2 et 3 / traduire le texte depuis l’anglais]. Après avoir utilisé cet outil, l’auteur ou les auteurs ont relu et modifié le contenu et assument l’entière responsabilité du contenu de la publication. »
Pour citer une réponse générée selon le style APA, l’auteur de l’outil est indiqué comme auteur, par exemple : OpenAI. (2023). ChatGPT (version du 14 mars) [Grand modèle de langage]. L’APA ayant publié de nouvelles consignes en septembre 2025, il convient de vérifier la version en vigueur.
Liste de contrôle avant soumission
- Chaque référence a été ouverte, lue et rapprochée de l’affirmation qu’elle soutient.
- Tous les chiffres ont été vérifiés à partir de mes propres données et de mon code.
- Aucune information permettant d’identifier une personne, aucune donnée confidentielle ou sous embargo n’a été saisie dans un outil d’IA.
- Les affirmations correspondent au dispositif de l’étude ; le langage causal est justifié.
- Le texte a été révisé avec ma propre voix ; je peux défendre chaque phrase.
- L’usage de l’IA est déclaré à l’endroit et sous la forme exigés par la revue.
- Aucune figure ni image générée ou modifiée par l’IA, sauf autorisation.
- Les coauteurs sont informés de l’usage de l’IA et l’approuvent.
Conclusion
Trois messages ressortent de cet article. D’abord, l’IA fait déjà partie de la rédaction scientifique : son adoption est élevée et croissante, et sa trace est détectable dans de nombreuses disciplines. La question est de savoir comment bien l’utiliser, non s’il faut l’utiliser. Ensuite, l’auteur demeure responsable : l’IA ne peut pas être auteur, et chaque affirmation, chaque chiffre et chaque référence engagent l’auteur humain, tandis que les données confidentielles doivent rester hors de ces outils. Enfin, la règle pratique tient en trois verbes : vérifier, réviser, déclarer.
Au-delà de la rédaction, l’IA pourrait modifier ce que les systèmes alimentaires peuvent savoir, et donc ce qu’ils peuvent accomplir. Mais cette promesse ne se réalisera que si les chercheurs appliquent aux résultats produits par l’IA la même discipline qu’à toute autre mesure : validation, transparence sur l’incertitude et attention à ceux dont les données et les savoirs restent invisibles.
Dr. John M. Ulimwengu
Chargé de recherches senior – Institut international de recherche sur les politiques alimentaires (IFPRI)
Références
COPE Council (2023). Authorship and AI tools: COPE position statement. Committee on Publication Ethics, 13 février 2023.
Elsevier (s.d.). Generative AI policies for journals. elsevier.com.
ICMJE (2025). Recommendations for the conduct, reporting, editing, and publication of scholarly work in medical journals (mise à jour).
Kobak, D., González-Márquez, R., Horvát, E.-Á., & Lause, J. (2025). Delving into LLM-assisted writing in biomedical publications through excess vocabulary. Science Advances. (Prépublication : arXiv:2406.07016)
Kwon, D. (2025). Is it OK for AI to write science papers? Nature survey shows researchers are split. Nature, 641.
Liang, W., et al. (2025). Quantifying large language model usage in scientific papers. Nature Human Behaviour. (Prépublication : arXiv:2404.01268)
McAdoo, T. (2023). How to cite ChatGPT. APA Style Blog (archivé ; nouvelles consignes de l’APA publiées en septembre 2025).
Springer Nature (s.d.). Editorial policies: Artificial intelligence (AI). springer.com.
Ulimwengu, J. M. (2026a). Have food systems been operating below their knowledge frontier? Article, version provisoire.
Ulimwengu, J. M. (2026b). Large language models as measurement instruments in applied economics: A 10-country public-discourse panel on food and nutrition security in Africa, 2010–2025. IFPRI Discussion Paper 1783.
van Wassenaer, L. (2026). Artificial intelligence and the foundations of food systems research. Nature Food, 7, 302–303.
Walters, W. H., & Wilder, E. I. (2023). Fabrication and errors in the bibliographic citations generated by ChatGPT. Scientific Reports, 13, 14045.
Wiley (2025). AI adoption jumps to 84% among researchers as expectations undergo significant reality check. Communiqué de presse, 7 octobre 2025 (ExplanAItions 2025).
Note : des outils d’IA générative ont été utilisés pour aider à la recherche documentaire, à la rédaction et à la traduction de cet article. L’auteur a relu, vérifié et révisé l’ensemble du contenu et en assume l’entière responsabilité.